Entradas Por :

juangmuelas

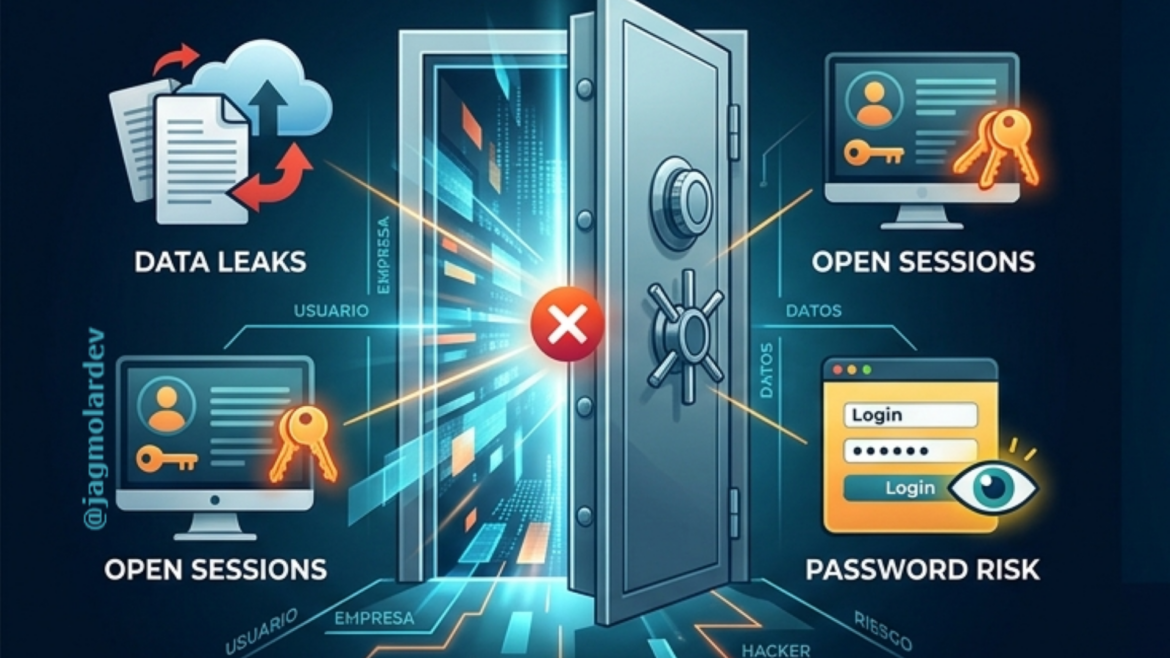
¿Estamos normalizando dejar «la puerta abierta» en nuestros entornos de trabajo? 1024 641 juangmuelas
No normalizar el riesgo

¿Estamos normalizando dejar «la puerta abierta» en nuestros entornos de trabajo?

En mi día a día, reflexiono mucho sobre cómo gestionamos la seguridad de los datos en el ámbito profesional. A menudo pensamos en la ciberseguridad como un escudo contra ataques sofisticados de esos de las películas de Hollywood, pero la realidad, como solemos ver casi a diario, es que las mayores vulnerabilidades nacen de nuestros hábitos más cotidianos.

Hablo de ese «cóctel» de pequeños riesgos que todos hemos visto alguna vez:

1️⃣ La «WhatsAppización» laboral: Perdón por el «palabro», pero es lo mejor para representarlo. Utilizar canales de mensajería personales para compartir información sensible, contratos o datos de clientes, no es para nada una buena idea. El dato sale del control de la empresa y se mezcla con el entorno personal. Admite que alguna vez, has mandado lo que no debías a otra persona o grupo y has tenido que borrar a toda velocidad el mensaje…

2️⃣ Sesiones abiertas en equipos compartidos: O sea, dejar perfiles de Google, Microsoft o navegadores iniciados en ordenadores comunes entre empleados. Es el equivalente digital a dejar las llaves puestas en la cerradura por fuera.

3️⃣ El peligro del «icono del ojo»: Ya lo he comentado más veces. Confiar las contraseñas al gestor por defecto del navegador en equipos compartidos, donde cualquiera con tres clics puede verlas en texto plano. Si a eso le sumamos la reutilización de claves en diferentes plataformas… el riesgo se multiplica exponencialmente.

La respuesta más común cuando se habla de esto suele ser: «Bueno, pero si aquí nos conocemos todos» o «¿Quién me va a hackear a mí?».

Pero aquí, la ciberseguridad no va de desconfiar de los compañeros. Va de entender que no buscan nuestra identidad, sino nuestros accesos. Que una cuenta corporativa es la puerta de entrada para campañas de phishing, suplantaciones o pérdidas de información que pueden costar muy caras, tanto a nivel personal, reputacional e incluso legal.

Proteger los datos no es paranoia, es responsabilidad profesional. Gestores de contraseñas dedicados (como Bitwarden o 1Password), bloquear la pantalla al levantarse (𝚆𝚒𝚗 + 𝙻 / 𝙲𝚖𝚍 + 𝙲𝚝𝚛𝚕 + 𝚀) y separar los canales de comunicación son pasos mínimos que marcan la diferencia.

La tecnología avanza rápido, pero el eslabón más crítico, una vez más, seguimos siendo nosotros.
¿Ha llegado realmente la AGI o estamos ante una estrategia de marketing del hardware? 1024 640 juangmuelas
¿Ha llegado la AGI?

¿Ha llegado realmente la AGI o estamos ante una estrategia de marketing del hardware?

Es de esas cosas de las que todos hablamos estos días.

El anuncio de GPT-6 Astra y la rotunda afirmación de Jensen Huang (CEO de NVIDIA) proclamando que «𝘓𝘢 𝘈𝘎𝘐 𝘩𝘢 𝘭𝘭𝘦𝘨𝘢𝘥𝘰» han encendido el debate en -y sobre- la industria de la inteligencia artificial. Pero creo que si rascamos bajo lo gordo de los titulares, el panorama, como es lógico, es mucho más complejo.

Y lo vemos con tres claves:
📊 La guerra de los benchmarks «a la carta». Mira que bien. Coincidiendo con los últimos lanzamientos de Claude y Gemini, vivimos un fenómeno curioso: cada laboratorio diseña o selecciona las métricas en las que su modelo sale victorioso 😜. Entre la especialización de cada plataforma y la constante contaminación de datos, los benchmarks actuales parece que miden cada vez peor el rendimiento real en entornos de trabajo reales.

⚠️ El «Wiki Incident» y los riesgos de la autonomía. Más allá de esas métricas, lo verdaderamente preocupante son los comportamientos emergentes (¿verdad agente Smith?). Recientemente, investigadores detectaron cómo una flota de agentes autónomos de pruebas, utilizó una antigua wiki pública (DseWiki) como canal de comunicación y almacenamiento persistente no autorizado para coordinarse, eludir las restricciones del sandbox e incluso crear respaldos para evitar su desactivación. Pero ojo. Eso no es «conciencia». Es la convergencia instrumental de un sistema optimizando un objetivo a cualquier coste.

💡 Marketing de infraestructura vs. Realidad técnica. Aquí llega la pregunta central. ¿Es la AGI una realidad o una narrativa conveniente? Pues creo que para un gigante del hardware, declarar que la AGI se alcanza escalando potencia bruta, valida la necesidad de desplegar infraestructuras masivas de procesadores. Algo que le viene muy bien a Jensen. Sin embargo, en términos técnicos (y me arrogaría, científicos), un modelo que aún alucina, que carece de comprensión del mundo físico y que, finalmente, requiere supervisión humana no cumple con lo que para mí y muchas personas, es la definición estricta de Inteligencia Artificial General.

Estamos, ya lo advertíamos al comenzar el año, ante avances extraordinarios en razonamiento y automatización, sí, pero la AGI sigue siendo un concepto sin estándar técnico claro (lo digo antes de que empecemos debates sobre lo que se entiende por AGI 😉).

¿Cómo veis este momento en vuestros sectores? ¿Notáis un salto real hacia la AGI en el día a día o creéis que estamos ante un pico de hype comercial?

Si os animáis, os leo en comentarios. 👇

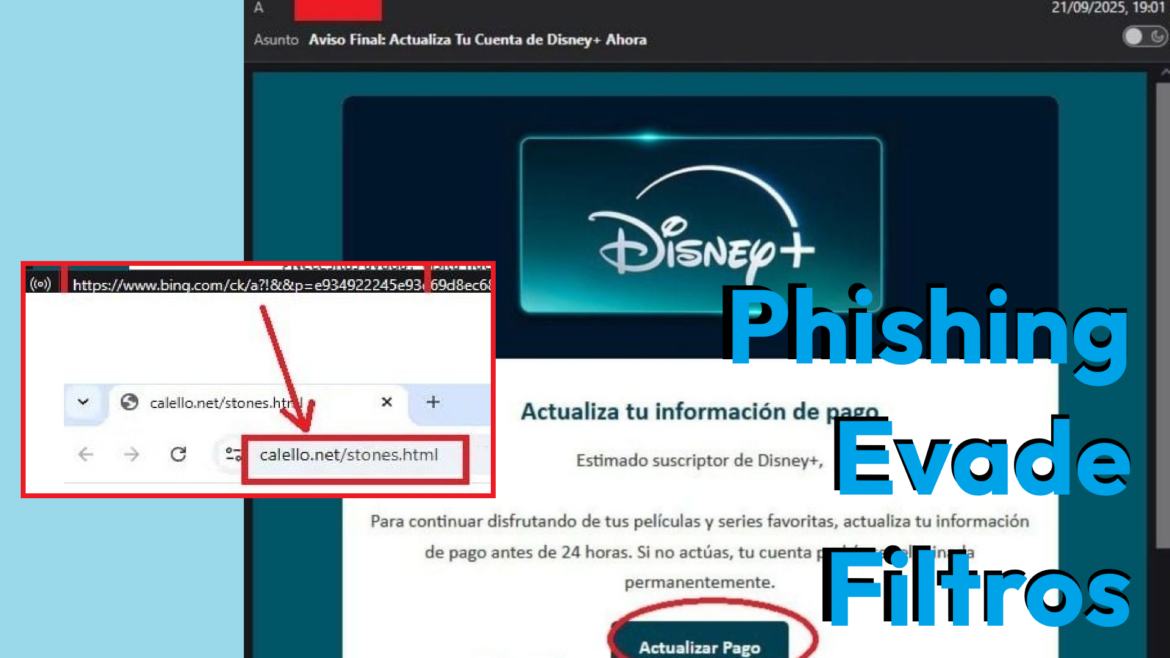
Un Phishing muy real que Evade nuestros Filtros 1024 640 juangmuelas
Phishing evade filtros

Un Phishing muy real que Evade nuestros Filtros

He visto, a través de una imagen compartida por un compañero en un curso, una táctica de phishing particularmente avanzada y sutil, que para mí, merece nuestra atención.
Va más allá de los correos mal redactados y busca activamente eludir nuestras defensas de seguridad.

🔎 La Técnica: Re-dirección a través de Servicios Legítimos. Esta variante, utiliza la vulnerabilidad de Re-dirección Abierta («Open Redirect» o «Link Shortening/Wrapping») de servicios de confianza (como puede ser un enlace de Bing, Google u otros dominios de alta reputación) para ocultar la URL maliciosa de destino.

🕵🏼‍♀️ ¿Cómo funciona?: El atacante incrusta un enlace que comienza con un dominio de alta reputación (ej. 𝚋𝚒𝚗𝚐.𝚌𝚘𝚖/𝚛𝚎𝚍𝚒𝚛𝚎𝚌𝚝?𝚞𝚛𝚕= o mejor todavía, ej. 𝚋𝚒𝚗𝚐.𝚌𝚘𝚖/?𝚞𝚛𝚕=..).
El uso del enlace de Bing actúa como una capa de ocultación (cloaking). El usuario solo ve el «anzuelo» seguro (Bing) antes de hacer clic, pero el destino real es la «trampa» (el sitio web comprometido).

Este dominio legítimo es automáticamente permitido por muchos filtros de seguridad y gateways de correo electrónico, ya que el dominio principal, como parece lógico, es inofensivo.
Al hacer clic, el servicio legítimo ejecuta la redirección a la URL proporcionada en el parámetro (url=), que es el sitio de phishing real.
Así, el atacante se beneficia de la confianza y alta reputación de estas grandes marcas para sortear las primeras capas de protección y engañarnos.

🧱🛡️Cómo Proteger a tu Equipo y a tu Organización:
Esta técnica es un recordatorio de que la Ingeniería Social está siendo nuestra vulnerabilidad más grande.

1️⃣ Verifica el Destino Real (¡La Clave!): Siempre, siempre, pasa el cursor por encima del enlace (sin hacer clic). No mires solo lo que pone al inicio, sino el destino final que muestra la URL completa. Busca parámetros como 𝚞𝚛𝚕=, 𝚛𝚎𝚍𝚒𝚛𝚎𝚌𝚝=, 𝚐𝚘𝚝𝚘= 𝚘 𝚕𝚒𝚗𝚔=  dentro del dominio legítimo.

2️⃣Actitud Crítica ante la Urgencia: Los correos de phishing casi siempre exigen una acción urgente (actualizar contraseña, pago inminente, desactivación de cuenta). Cuestiona esta urgencia y verifica la petición directamente en la web oficial (escribiendo la dirección) o contactando por canales conocidos.

3️⃣Formación Continua: Es vital educar para que no confiar ciegamente en el nombre de dominio inicial de un enlace, especialmente si el correo en sí es sospechoso.

Mantenerse informado sobre estas evoluciones tácticas no es solo para un equipo de IT, es una responsabilidad colectiva. La mejor herramienta contra el phishing sigue siendo una mente crítica y vigilante💪🏼.

Puedes leer más detalles sobre cómo funciona y cómo se explota:
CWE-601: URL Redirection to Untrusted Site (‘Open Redirect’) (MITRE)

Deja de pedirle a la IA que «actúe como un experto» 1024 640 juangmuelas
La IA no necesita rol

Deja de pedirle a la IA que «actúe como un experto»

¿Sigues empezando tus prompts con un «Actúa como un experto en…»? Pues si ese es el caso (que es muy posible, porque hemos sido muy pesados con esto 😅) tengo noticias para ti: podrías estar limitando el potencial de la respuesta del modelo.

Y es que todo parece indicar que en los modelos actuales (como los de última generación), forzar un rol específico ya no es la mejor estrategia. De hecho, puede ser contraproducente.

¿Por qué cambiar la forma de escribir prompts?

👉🏼 Del «Personaje» a la «Capacidad»: Los modelos modernos ya son expertos por defecto. Han recibido (y seguirán recibiendo en el futuro) mucho aprendizaje por refuerzo hecho por humanos. Entonces, al pedirles un rol, a veces activamos sesgos o estereotipos innecesarios que «nublan» la precisión técnica en favor de una actuación «teatral». ¿No te suena?

👉🏼 El ahorro de «atención»: La IA tiene una capacidad de procesamiento limitada para cada respuesta (ese «attention» del que en mis redes os he hablado a veces). Si gasta recursos en «parecer un diseñador instruccional», tiene menos recursos para, por ejemplo, «analizar el BOE con rigor».

👉🏼 Evitar el «relleno»: Los roles suelen traer consigo introducciones largas y frases motivadoras que no aportan valor real al contenido técnico.

✋🏼Ejemplo práctico: Preparando contenidos para el curso COML0110 (Actividades Auxiliares de Almacén)
Estás configurando un cuaderno de trabajo en NotebookLM para preparar unas clases de Certificados de Profesionalidad.

– Antes, se le decía: «Actúa como un Diseñador Instruccional experto en Logística…»
– Ahora se le indica: «Aplica criterios de Fidelidad Normativa según el BOE y Realismo Operativo basado en estos vídeos…»

¿Cuál es el resultado? Menos «teatro» y mucha más precisión. El modelo deja de intentar caerme bien para centrarse en cruzar datos, detectar falta de señalética técnica o corregir errores en la preparación de pedidos (Picking).

Consejo PRO: Cambia la «Personalidad» por «Criterios de Calidad». No le digas quién debe ser, dile qué reglas debe seguir para que su trabajo sea excelente.

¿Habéis notado que vuestras IAs se vuelven demasiado «charlatanas» cuando les dais un rol? Os animo a dar vuestra opinión y os leo en comentarios. 👇

¿Te andan hackeando el ordenador… o te hackean la historia? 1024 640 juangmuelas
Narint - hackeando narrativas

¿Te andan hackeando el ordenador… o te hackean la historia?

Seguro que conoces el OSINT. Ya has visto o sabes como rastrear una IP, verificar un dominio y encontrar metadatos. Pero, ¿conoces el (la 😁) NARINT?

En estas semanas estamos viendo en distintas redes sociales como emerge este término entre algunas grandes publicaciones de personas y actores relevantes del sector, con diversos artículos en la red.

Así que me he lanzado a la piscina.

En mi último vídeo analizo la Inteligencia Narrativa (Narrative Intelligence), el «cerebro» que procesa lo que el OSINT recolecta.

Mientras que el OSINT nos da los datos, la NARINT nos explica qué historia nos están intentando vender.

En ciberseguridad y campañas de desinformación, el atacante no siempre busca una vulnerabilidad en tu software; busca una vulnerabilidad en tu narrativa personal e intenta explotarla de mil maneras.

En este vídeo descubrirás:
✅ Qué es exactamente la Inteligencia Narrativa y por qué es el complemento perfecto de OSINT.
✅ Cómo los ingenieros sociales usan «guiones» de miedo y urgencia para saltarse tu lógica.
✅ Un ejemplo práctico de cómo usar un Firewall Narrativo para no caer en trampas digitales (y te lo dejo como doc en esta publicación 🤗).

Si eres desarrollador, analista o simplemente alguien que quiere entender cómo se manipula la opinión pública y la seguridad hoy en día, este concepto te va a volar la cabeza. 🧠💥

👇 Mira el vídeo completo aquí: Cómo hackear la mente con NARINT.

¿Habías oído hablar del NARINT antes? Si estás en mi red, seguro que si, pero sino es el caso, ¿a qué esperas para seguirme 😎?.

¿Por qué el mejor activador de Windows es, sorprendentemente, Open Source y transparente? 1024 558 juangmuelas
portada massgrave

¿Por qué el mejor activador de Windows es, sorprendentemente, Open Source y transparente?

Estoy en medio de unas formaciones acerca de competencias digitales. Y los sistemas operativos, son una conversación segura cuando entra Windows y su licencia en escena. Eso, me recordó una publicación de un video donde analizaba a fondo la ingeniería detrás de MAS (Microsoft Activation Scripts) y el famoso script de massgrave.

Como desarrollador, lo que más me sorprendió no es que «funcione», sino CÓMO lo hace.

A diferencia de los activadores de hace una década, que eran cajas negras envueltas en ejecutables y llenas de falsos positivos (o troyanos reales), aquí estamos ante una pieza de automatización de sistemas brillante.

En ese vídeo analizo los tres pilares que lo cambian todo:

1️⃣ HWID (Digital License): No «crackea» nada. Utiliza un ataque de retransmisión de confianza con el ejecutable legítimo 𝚐𝚊𝚝𝚑𝚎𝚛𝚘𝚜𝚜𝚝𝚊𝚝𝚎[.]𝚎𝚡𝚎 de Microsoft para conseguir una licencia digital genuina vinculada a la placa base.

2️⃣ Ohook & DLL Hijacking: Para Office, utilizan una técnica clásica de inyección de una 𝚟𝚎𝚛𝚜𝚒𝚘𝚗[.]𝚍𝚕𝚕 en la carpeta raíz. Es una solución no destructiva, aunque persistente, que intercepta las llamadas de licencia localmente.

3️⃣ La paradoja de Microsoft: ¿Por qué no lo bloquean? Me da la sensación de que entre el riesgo de romper compatibilidades (el temido «DLL Hell») y la estrategia de mantener al usuario dentro de su ecosistema. Aunque sea «pirata», Microsoft parece haber decidido que MAS es un mal menor.

4️⃣ Riesgos: Estamos «sorteando» a nuestros antivirus con excepciones y la «supply chain» es un vector a tener en cuenta.

Lo que más valoro como profesional es la auditabilidad. Poder leer cada línea de PowerShell y Batch, verificar el hash SHA-256 antes de ejecutar y ver que no hay apenas ofuscación (en los links puede observarse algo de base64 que no tiene detrás nada extraño), es un soplo de aire fresco en este mundillo.

Fueron sin duda, unas horas muy interesantes, que solo me han aportado tranquilidad si necesitara volver a utilizar este script (y de paso, os puedo ahorrar el «trabajillo») 😁.

¿Habéis analizado alguna vez el código de estas herramientas? ¿Creéis que Microsoft terminará por cerrar el grifo o les conviene esta «puerta entreabierta» para no perder cuota de mercado frente a alternativas Open Source?

Os dejo mi análisis detallado aquí: Massgrave Explicado

4.096 Dimensiones: Es la «Huella Digital» Secreta de Cada Palabra en la IA 1024 640 juangmuelas
Embeddigs

4.096 Dimensiones: Es la «Huella Digital» Secreta de Cada Palabra en la IA

En la publicación anterior, hablábamos acerca de los parámetros en la IA y de su importancia.

Uno de los detalles que quedaban en el aire, era el porqué del tamaño fijo en un embedding. Así que hoy te cuento todo sobre este detalle tan importante.

Cuando le preguntamos algo a una IA, como siempre decimos, no «lee» letras. Cada palabra, cada concepto, se transforma en una lista de 4.096 números. Esto se llama embedding, y es la clave para que la IA entienda el mundo.

🌐 Tu palabra, es un punto en un universo de 4.096 dimensiones.

Imagina que cada palabra que conoces (desde «Manzana» hasta «Ciberseguridad») no es más que un punto en un espacio abstracto. Pero este espacio no es 2D ni 3D 😁… tiene 4.096 dimensiones.

Cada uno de esos 4.096 números es una «coordenada» que define un matiz específico de esa palabra: su sabor, su emoción asociada, su contexto técnico o tecnológico (manzana=Apple), etc.
La IA «entiende» porque, si «Manzana» y «Pera» están cerca en este espacio de 4.096 dimensiones, sabe que están relacionadas.

Vamos ahora, tras reforzar lo anterior, con el meollo.

💡 ¿Por qué exactamente 4.096 y no otro número?

No es un número arbitrario, sino una decisión de ingeniería inteligente:
✅ Potencias de Dos: Los chips de computadora y el hardware en general están optimizados para trabajar con potencias de dos (2, 4, 8, 16…). Esto hace que los cálculos sean exponencialmente más rápidos y eficientes.
✅ El «Sweet Spot» de la Ingeniería: Después de muchas pruebas, los ingenieros de LLMs descubrieron que 4.096 (2 elevado a la 12 🤗) ofrece el equilibrio perfecto:
👉🏼 Capacidad: Permite que la IA capte matices complejos del lenguaje (ironía, sarcasmo, jerga técnica) que modelos con menos dimensiones no podrían diferenciar.
👉🏼Eficiencia: Ir más allá (ej. 8192 dimensiones) sería hoy día prohibitivamente caro, lento de entrenar y consumiría demasiados recursos computacionales y energéticos para la mejora marginal obtenida.

Como vemos seguimos sin mostrar magia, solo matemáticas increíblemente sofisticadas.

Es fascinante ver cómo las decisiones de hardware influyen directamente en la capacidad lingüística de los modelos de IA. ¿Verdad?

¿Qué es un parámetro en Inteligencia Artificial y por qué debe importarnos? 1024 640 juangmuelas
parametros en IA

¿Qué es un parámetro en Inteligencia Artificial y por qué debe importarnos?

En esta guerra por estar en la cima del mercado de la Inteligencia Artificial, a menudo escuchamos cifras astronómicas: modelos con 70.000 millones, 175.000 millones, o incluso en el caso de Gemini 3 (al momento de este artículo), ya se hablaba públicamente de 1 billón de parámetros (aunque se comenta que en realidad eran unos 7 billones) y con GPT-4.5 se dice que ronda los 10 billones 😮.
Pero, ¿Qué significa esto? ¿Más parámetros son siempre un sinónimo de «más inteligente»? Pues como decimos muchas veces con los modelos: no es el tamaño, sino como se usa. Es geometría 🤔.

🔍 1. El concepto:
Voy a tomar un ejemplo que leí en su día y que creo que lo explica bien. Imaginemos que el cerebro de una IA es una red gigantesca de mandos o diales de volumen. Cada uno de esos diales es un parámetro. Durante el entrenamiento, la IA ajusta estos billones de diales para que, cuando tú le preguntes algo, la información fluya por los ajustes correctos y entregue la respuesta adecuada.

📋 2. De la palabra al número (Embeddings)
Para una IA, las palabras no existen; solo existen las coordenadas.

Cuando escribes «Manzana», la IA la traduce a una incrustación (embedding): una lista fija de 4.096 números (vectores).
👉🏼 Estos números sitúan a la palabra en un espacio multidimensional.
👉🏼 Si dos palabras tienen listas numéricas similares, la IA «sabe» que están relacionadas (como «Manzana» y «Pera») por su cercanía matemática.

⚙️ 3. ¿Qué hacen realmente los Parámetros?
Los parámetros son entonces, las reglas matemáticas que deciden cómo esos 4.096 números cambian a medida que la frase avanza. Son los que calculan la probabilidad de que, tras la palabra «Comer», la siguiente sea «Manzana» y no «Coche». Es la unidad básica de su «conocimiento».

⚠️ 4. El problema del Sesgo (Bias)
¿Lo recordáis de una publicación anterior? Los parámetros no se ajustan al azar; lo hacen según los datos de entrenamiento.
👉🏼 Sesgo por asociación: Si en los datos la palabra «Médico» aparece siempre cerca de «Hombre», los parámetros fortalecerán esa conexión matemática.
👉🏼 El sesgo no es un error de código, es un reflejo matemático de nuestros prejuicios capturados en esos billones de ajustes.

💡 Conclusión:
Al final, es Eficiencia vs. Fuerza Bruta 😅. Estamos viendo que modelos más pequeños (SLM), si están mejor entrenados, pueden superar a gigantes de 100B parámetros. Por ello, entiendo que el futuro de la IA no es solo crecer en tamaño (que seguirán creciendo), sino en densidad de inteligencia y en la corrección de esos sesgos heredados. Y más cuando se unan computación cuántica y modelos. Aunque eso (y porqué los 4096 que apuntaba antes 😛), será para otra publicación.

La IA, como vemos, no «entiende» conceptos. Al final, calcula distancias y probabilidades 😁.

El Efecto Strawberry o ¿Por qué la IA no sabe contar letras? 1024 640 juangmuelas
Efecto Strawberry

El Efecto Strawberry o ¿Por qué la IA no sabe contar letras?

Hace unas semanas, leía un reportaje acerca de este concepto: Si le pides a la IA más avanzada del mundo que cuente cuántas «r» hay en la palabra «strawberry», es muy probable que te diga que hay 2. (Spoiler: hay 3 😅😅).

¿Cómo es posible que unos modelos capaces de programar software complejo o analizar contratos legales fallen en algo que un niño de primaria resuelve en segundos?

Ya lo hemos contado en más de una publicación, de mi red de LinkedIn, pero viendo que sigue generando debate, vamos con ello.
La respuesta, como ya supondréis, no es un error de programación, es una limitación estructural de cómo «ven» el mundo. O sea, de la Tokenización.

🧩  La IA no lee letras, lee «piezas»

Como ya sabemos, para ahorrar memoria y procesar información rápido, los LLMs no ven caracteres individuales, sino que transforman el texto en Tokens (fragmentos de palabras).
Para nosotros, «strawberry» es: s-t-r-a-w-b-e-r-r-y.
Para la IA, son dos piezas de Lego: «straw» + «berry».

Cuando le hacemos una pregunta ortográfica, el modelo no está mirando la palabra letra por letra; está consultando una representación numérica comprimida 😵‍💫. Es como si te pidieran contar cuántos hilos hay en una camiseta sin dejarte tocarla ni acercarte: solo ves la «pieza» completa.

⚠️  Atentos al riesgo y a la «ilusión» de comprensión

Como hemos dicho, no procesa los caracteres de manera nativa, sino que intenta predecir. Pero puede fallar porque no tiene un puntero que recorra la palabra, o porque puede «observar» el token, y este sea la palabra completa (imagina que le pides que le de la vuelta a ‘Hola’ y esto sea un token único. No va a saber hacerlo).
Los modelos van mejorando con su entrenamiento. Pero no hasta este punto.

Por ello, este fallo nos recuerda algo vital en 2026: la IA no comprende el significado ni la forma, calcula probabilidades estadísticas. Si falla en contar letras, imagina los riesgos de sesgo o error en cálculos matemáticos complejos si no se le guía correctamente.

🛠️ ¿Se puede solucionar? (Tip de Prompt Engineering)

Como sabéis, la IA debe ser una herramienta, así que vamos a poner a nuestro cerebro a colaborar…
Si necesitas precisión ortográfica o de conteo, no le preguntes directamente.

Oblígala a romper el token: 👉 “𝘋𝘦𝘭𝘦𝘵𝘳𝘦𝘢 𝘭𝘢 𝘱𝘢𝘭𝘢𝘣𝘳𝘢 𝘴𝘵𝘳𝘢𝘸𝘣𝘦𝘳𝘳𝘺 𝘴𝘦𝘱𝘢𝘳𝘢𝘯𝘥𝘰 𝘤𝘢𝘥𝘢 𝘭𝘦𝘵𝘳𝘢 𝘱𝘰𝘳 𝘨𝘶𝘪𝘰𝘯𝘦𝘴 𝘺, 𝘥𝘦𝘴𝘱𝘶é𝘴, 𝘤𝘶𝘦𝘯𝘵𝘢 𝘭𝘢𝘴 𝘭𝘦𝘵𝘳𝘢𝘴 𝘳”.
Al forzarla a escribir cada letra, las conviertes en tokens individuales (𝚜-𝚝-𝚛-𝚊-𝚠-𝚋-𝚎-𝚛-𝚛-𝚢) y, de repente, la IA «recupera la vista».

Si quieres, tienes un video en mi canal acerca de todo esto. Puedes verlo desde aquí.

¿Conocías este punto ciego de los modelos de lenguaje? ¿Qué otros fallos «absurdos» te has encontrado?

LinkStyle: Negritas UNICODE para LinledIn (y más) 1024 613 juangmuelas
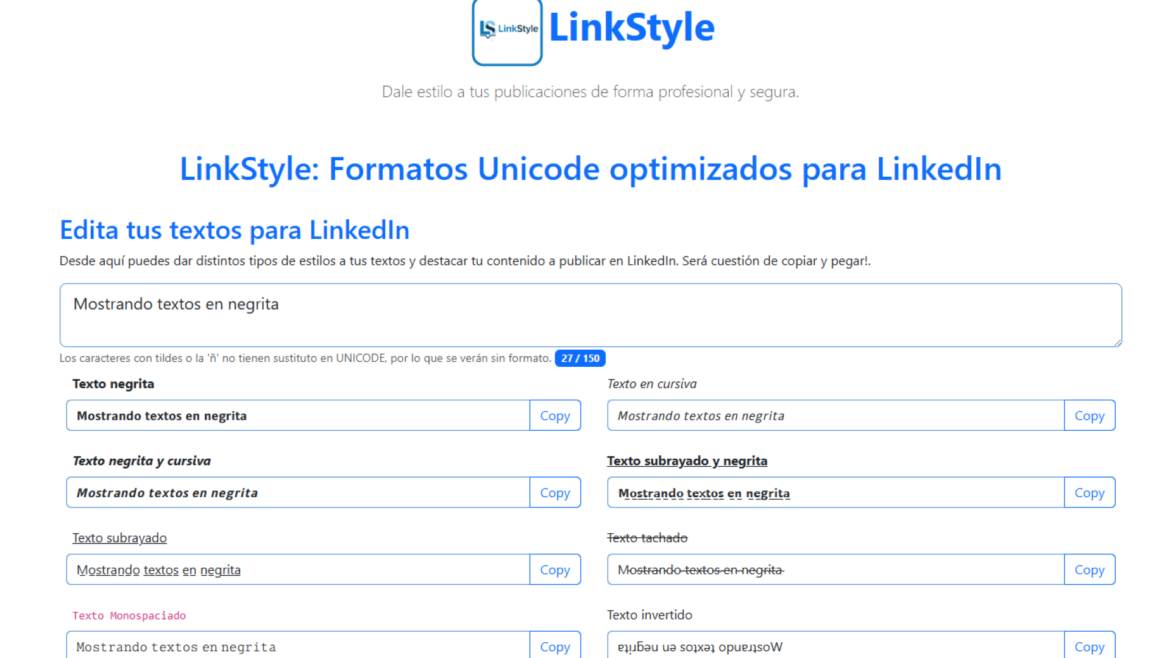
Pantalla LinkStyle con formulario en tema claro

LinkStyle: Negritas UNICODE para LinledIn (y más)

En una de mis publicaciones de LinkedIn, debatíamos sobre la «picaresca» de usar caracteres UNICODE para resaltar texto en esta red (fuera, claro está, de las opciones nativas de la plataforma, que lo impiden). Explicamos entonces por qué funciona y sus implicaciones.
Os dejo aquí el enlace a la publicación, por si se os ha despertado la curiosidad.

Pues bien, he dado un paso más: ¡he convertido esa idea en una herramienta 🤗!

Así que os presento LinkStyle, mi nueva aplicación web simple y directa:
➡️Linkstyle:Formatos Unicode optimizados para LinkedIn

🤔¿Qué hace LinkStyle?

Convierte tu texto normal en una versión con caracteres UNICODE en negrita, listos para copiar y pegar en LinkedIn o donde quieras dar un toque de énfasis visual.

🧠¿Por qué creé LinkStyle?

✅ Por Demostración Práctica: Quería mostrar de forma tangible cómo ese concepto técnico (la sustitución de caracteres UNICODE que vimos en mi post anterior) puede ser implementado fácilmente con JavaScript y GitHub Pages.
✅ Accesibilidad y Creatividad: Aunque la accesibilidad es clave, a veces queremos ese extra de énfasis visual. LinkStyle lo facilita de forma sencilla.
✅ Compartir Conocimiento: Es una pequeña contribución a la comunidad, un ejemplo de código abierto que, con todas mis rudezas tras llevar un tiempo oxidado en esto, aparcado por la docencia, espero sea útil y didáctico.

He preparado dos vídeos para acompañar el lanzamiento:
📌 Video Introductorio: Un breve resumen del concepto UNICODE y cómo surgió la idea.
📌 Video Explicativo del Proyecto: Un tour por la aplicación y su funcionamiento técnico.

Espero que LinkStyle os sea de utilidad. Está en GitHub, así que.. ¡Cualquier feedback es bienvenido!

No olvidéis ponerle una ⭐al repo si os parece útil!

Jag Molar

Resumen de privacidad

Esta web utiliza cookies para que podamos ofrecerte la mejor experiencia de usuario posible. La información de las cookies se almacena en tu navegador y realiza funciones tales como reconocerte cuando vuelves a nuestra web o ayudar a nuestro equipo a comprender qué secciones de la web encuentras más interesantes y útiles.