Inteligencia Artificial

¿Ha llegado realmente la AGI o estamos ante una estrategia de marketing del hardware? 1024 640 juangmuelas
¿Ha llegado la AGI?

¿Ha llegado realmente la AGI o estamos ante una estrategia de marketing del hardware?

Es de esas cosas de las que todos hablamos estos días.

El anuncio de GPT-6 Astra y la rotunda afirmación de Jensen Huang (CEO de NVIDIA) proclamando que «𝘓𝘢 𝘈𝘎𝘐 𝘩𝘢 𝘭𝘭𝘦𝘨𝘢𝘥𝘰» han encendido el debate en -y sobre- la industria de la inteligencia artificial. Pero creo que si rascamos bajo lo gordo de los titulares, el panorama, como es lógico, es mucho más complejo.

Y lo vemos con tres claves:
📊 La guerra de los benchmarks «a la carta». Mira que bien. Coincidiendo con los últimos lanzamientos de Claude y Gemini, vivimos un fenómeno curioso: cada laboratorio diseña o selecciona las métricas en las que su modelo sale victorioso 😜. Entre la especialización de cada plataforma y la constante contaminación de datos, los benchmarks actuales parece que miden cada vez peor el rendimiento real en entornos de trabajo reales.

⚠️ El «Wiki Incident» y los riesgos de la autonomía. Más allá de esas métricas, lo verdaderamente preocupante son los comportamientos emergentes (¿verdad agente Smith?). Recientemente, investigadores detectaron cómo una flota de agentes autónomos de pruebas, utilizó una antigua wiki pública (DseWiki) como canal de comunicación y almacenamiento persistente no autorizado para coordinarse, eludir las restricciones del sandbox e incluso crear respaldos para evitar su desactivación. Pero ojo. Eso no es «conciencia». Es la convergencia instrumental de un sistema optimizando un objetivo a cualquier coste.

💡 Marketing de infraestructura vs. Realidad técnica. Aquí llega la pregunta central. ¿Es la AGI una realidad o una narrativa conveniente? Pues creo que para un gigante del hardware, declarar que la AGI se alcanza escalando potencia bruta, valida la necesidad de desplegar infraestructuras masivas de procesadores. Algo que le viene muy bien a Jensen. Sin embargo, en términos técnicos (y me arrogaría, científicos), un modelo que aún alucina, que carece de comprensión del mundo físico y que, finalmente, requiere supervisión humana no cumple con lo que para mí y muchas personas, es la definición estricta de Inteligencia Artificial General.

Estamos, ya lo advertíamos al comenzar el año, ante avances extraordinarios en razonamiento y automatización, sí, pero la AGI sigue siendo un concepto sin estándar técnico claro (lo digo antes de que empecemos debates sobre lo que se entiende por AGI 😉).

¿Cómo veis este momento en vuestros sectores? ¿Notáis un salto real hacia la AGI en el día a día o creéis que estamos ante un pico de hype comercial?

Si os animáis, os leo en comentarios. 👇
Deja de pedirle a la IA que «actúe como un experto» 1024 640 juangmuelas
La IA no necesita rol

Deja de pedirle a la IA que «actúe como un experto»

¿Sigues empezando tus prompts con un «Actúa como un experto en…»? Pues si ese es el caso (que es muy posible, porque hemos sido muy pesados con esto 😅) tengo noticias para ti: podrías estar limitando el potencial de la respuesta del modelo.

Y es que todo parece indicar que en los modelos actuales (como los de última generación), forzar un rol específico ya no es la mejor estrategia. De hecho, puede ser contraproducente.

¿Por qué cambiar la forma de escribir prompts?

👉🏼 Del «Personaje» a la «Capacidad»: Los modelos modernos ya son expertos por defecto. Han recibido (y seguirán recibiendo en el futuro) mucho aprendizaje por refuerzo hecho por humanos. Entonces, al pedirles un rol, a veces activamos sesgos o estereotipos innecesarios que «nublan» la precisión técnica en favor de una actuación «teatral». ¿No te suena?

👉🏼 El ahorro de «atención»: La IA tiene una capacidad de procesamiento limitada para cada respuesta (ese «attention» del que en mis redes os he hablado a veces). Si gasta recursos en «parecer un diseñador instruccional», tiene menos recursos para, por ejemplo, «analizar el BOE con rigor».

👉🏼 Evitar el «relleno»: Los roles suelen traer consigo introducciones largas y frases motivadoras que no aportan valor real al contenido técnico.

✋🏼Ejemplo práctico: Preparando contenidos para el curso COML0110 (Actividades Auxiliares de Almacén)
Estás configurando un cuaderno de trabajo en NotebookLM para preparar unas clases de Certificados de Profesionalidad.

– Antes, se le decía: «Actúa como un Diseñador Instruccional experto en Logística…»
– Ahora se le indica: «Aplica criterios de Fidelidad Normativa según el BOE y Realismo Operativo basado en estos vídeos…»

¿Cuál es el resultado? Menos «teatro» y mucha más precisión. El modelo deja de intentar caerme bien para centrarse en cruzar datos, detectar falta de señalética técnica o corregir errores en la preparación de pedidos (Picking).

Consejo PRO: Cambia la «Personalidad» por «Criterios de Calidad». No le digas quién debe ser, dile qué reglas debe seguir para que su trabajo sea excelente.

¿Habéis notado que vuestras IAs se vuelven demasiado «charlatanas» cuando les dais un rol? Os animo a dar vuestra opinión y os leo en comentarios. 👇

4.096 Dimensiones: Es la «Huella Digital» Secreta de Cada Palabra en la IA 1024 640 juangmuelas
Embeddigs

4.096 Dimensiones: Es la «Huella Digital» Secreta de Cada Palabra en la IA

En la publicación anterior, hablábamos acerca de los parámetros en la IA y de su importancia.

Uno de los detalles que quedaban en el aire, era el porqué del tamaño fijo en un embedding. Así que hoy te cuento todo sobre este detalle tan importante.

Cuando le preguntamos algo a una IA, como siempre decimos, no «lee» letras. Cada palabra, cada concepto, se transforma en una lista de 4.096 números. Esto se llama embedding, y es la clave para que la IA entienda el mundo.

🌐 Tu palabra, es un punto en un universo de 4.096 dimensiones.

Imagina que cada palabra que conoces (desde «Manzana» hasta «Ciberseguridad») no es más que un punto en un espacio abstracto. Pero este espacio no es 2D ni 3D 😁… tiene 4.096 dimensiones.

Cada uno de esos 4.096 números es una «coordenada» que define un matiz específico de esa palabra: su sabor, su emoción asociada, su contexto técnico o tecnológico (manzana=Apple), etc.
La IA «entiende» porque, si «Manzana» y «Pera» están cerca en este espacio de 4.096 dimensiones, sabe que están relacionadas.

Vamos ahora, tras reforzar lo anterior, con el meollo.

💡 ¿Por qué exactamente 4.096 y no otro número?

No es un número arbitrario, sino una decisión de ingeniería inteligente:
✅ Potencias de Dos: Los chips de computadora y el hardware en general están optimizados para trabajar con potencias de dos (2, 4, 8, 16…). Esto hace que los cálculos sean exponencialmente más rápidos y eficientes.
✅ El «Sweet Spot» de la Ingeniería: Después de muchas pruebas, los ingenieros de LLMs descubrieron que 4.096 (2 elevado a la 12 🤗) ofrece el equilibrio perfecto:
👉🏼 Capacidad: Permite que la IA capte matices complejos del lenguaje (ironía, sarcasmo, jerga técnica) que modelos con menos dimensiones no podrían diferenciar.
👉🏼Eficiencia: Ir más allá (ej. 8192 dimensiones) sería hoy día prohibitivamente caro, lento de entrenar y consumiría demasiados recursos computacionales y energéticos para la mejora marginal obtenida.

Como vemos seguimos sin mostrar magia, solo matemáticas increíblemente sofisticadas.

Es fascinante ver cómo las decisiones de hardware influyen directamente en la capacidad lingüística de los modelos de IA. ¿Verdad?

¿Qué es un parámetro en Inteligencia Artificial y por qué debe importarnos? 1024 640 juangmuelas
parametros en IA

¿Qué es un parámetro en Inteligencia Artificial y por qué debe importarnos?

En esta guerra por estar en la cima del mercado de la Inteligencia Artificial, a menudo escuchamos cifras astronómicas: modelos con 70.000 millones, 175.000 millones, o incluso en el caso de Gemini 3 (al momento de este artículo), ya se hablaba públicamente de 1 billón de parámetros (aunque se comenta que en realidad eran unos 7 billones) y con GPT-4.5 se dice que ronda los 10 billones 😮.
Pero, ¿Qué significa esto? ¿Más parámetros son siempre un sinónimo de «más inteligente»? Pues como decimos muchas veces con los modelos: no es el tamaño, sino como se usa. Es geometría 🤔.

🔍 1. El concepto:
Voy a tomar un ejemplo que leí en su día y que creo que lo explica bien. Imaginemos que el cerebro de una IA es una red gigantesca de mandos o diales de volumen. Cada uno de esos diales es un parámetro. Durante el entrenamiento, la IA ajusta estos billones de diales para que, cuando tú le preguntes algo, la información fluya por los ajustes correctos y entregue la respuesta adecuada.

📋 2. De la palabra al número (Embeddings)
Para una IA, las palabras no existen; solo existen las coordenadas.

Cuando escribes «Manzana», la IA la traduce a una incrustación (embedding): una lista fija de 4.096 números (vectores).
👉🏼 Estos números sitúan a la palabra en un espacio multidimensional.
👉🏼 Si dos palabras tienen listas numéricas similares, la IA «sabe» que están relacionadas (como «Manzana» y «Pera») por su cercanía matemática.

⚙️ 3. ¿Qué hacen realmente los Parámetros?
Los parámetros son entonces, las reglas matemáticas que deciden cómo esos 4.096 números cambian a medida que la frase avanza. Son los que calculan la probabilidad de que, tras la palabra «Comer», la siguiente sea «Manzana» y no «Coche». Es la unidad básica de su «conocimiento».

⚠️ 4. El problema del Sesgo (Bias)
¿Lo recordáis de una publicación anterior? Los parámetros no se ajustan al azar; lo hacen según los datos de entrenamiento.
👉🏼 Sesgo por asociación: Si en los datos la palabra «Médico» aparece siempre cerca de «Hombre», los parámetros fortalecerán esa conexión matemática.
👉🏼 El sesgo no es un error de código, es un reflejo matemático de nuestros prejuicios capturados en esos billones de ajustes.

💡 Conclusión:
Al final, es Eficiencia vs. Fuerza Bruta 😅. Estamos viendo que modelos más pequeños (SLM), si están mejor entrenados, pueden superar a gigantes de 100B parámetros. Por ello, entiendo que el futuro de la IA no es solo crecer en tamaño (que seguirán creciendo), sino en densidad de inteligencia y en la corrección de esos sesgos heredados. Y más cuando se unan computación cuántica y modelos. Aunque eso (y porqué los 4096 que apuntaba antes 😛), será para otra publicación.

La IA, como vemos, no «entiende» conceptos. Al final, calcula distancias y probabilidades 😁.

El Efecto Strawberry o ¿Por qué la IA no sabe contar letras? 1024 640 juangmuelas
Efecto Strawberry

El Efecto Strawberry o ¿Por qué la IA no sabe contar letras?

Hace unas semanas, leía un reportaje acerca de este concepto: Si le pides a la IA más avanzada del mundo que cuente cuántas «r» hay en la palabra «strawberry», es muy probable que te diga que hay 2. (Spoiler: hay 3 😅😅).

¿Cómo es posible que unos modelos capaces de programar software complejo o analizar contratos legales fallen en algo que un niño de primaria resuelve en segundos?

Ya lo hemos contado en más de una publicación, de mi red de LinkedIn, pero viendo que sigue generando debate, vamos con ello.
La respuesta, como ya supondréis, no es un error de programación, es una limitación estructural de cómo «ven» el mundo. O sea, de la Tokenización.

🧩  La IA no lee letras, lee «piezas»

Como ya sabemos, para ahorrar memoria y procesar información rápido, los LLMs no ven caracteres individuales, sino que transforman el texto en Tokens (fragmentos de palabras).
Para nosotros, «strawberry» es: s-t-r-a-w-b-e-r-r-y.
Para la IA, son dos piezas de Lego: «straw» + «berry».

Cuando le hacemos una pregunta ortográfica, el modelo no está mirando la palabra letra por letra; está consultando una representación numérica comprimida 😵‍💫. Es como si te pidieran contar cuántos hilos hay en una camiseta sin dejarte tocarla ni acercarte: solo ves la «pieza» completa.

⚠️  Atentos al riesgo y a la «ilusión» de comprensión

Como hemos dicho, no procesa los caracteres de manera nativa, sino que intenta predecir. Pero puede fallar porque no tiene un puntero que recorra la palabra, o porque puede «observar» el token, y este sea la palabra completa (imagina que le pides que le de la vuelta a ‘Hola’ y esto sea un token único. No va a saber hacerlo).
Los modelos van mejorando con su entrenamiento. Pero no hasta este punto.

Por ello, este fallo nos recuerda algo vital en 2026: la IA no comprende el significado ni la forma, calcula probabilidades estadísticas. Si falla en contar letras, imagina los riesgos de sesgo o error en cálculos matemáticos complejos si no se le guía correctamente.

🛠️ ¿Se puede solucionar? (Tip de Prompt Engineering)

Como sabéis, la IA debe ser una herramienta, así que vamos a poner a nuestro cerebro a colaborar…
Si necesitas precisión ortográfica o de conteo, no le preguntes directamente.

Oblígala a romper el token: 👉 “𝘋𝘦𝘭𝘦𝘵𝘳𝘦𝘢 𝘭𝘢 𝘱𝘢𝘭𝘢𝘣𝘳𝘢 𝘴𝘵𝘳𝘢𝘸𝘣𝘦𝘳𝘳𝘺 𝘴𝘦𝘱𝘢𝘳𝘢𝘯𝘥𝘰 𝘤𝘢𝘥𝘢 𝘭𝘦𝘵𝘳𝘢 𝘱𝘰𝘳 𝘨𝘶𝘪𝘰𝘯𝘦𝘴 𝘺, 𝘥𝘦𝘴𝘱𝘶é𝘴, 𝘤𝘶𝘦𝘯𝘵𝘢 𝘭𝘢𝘴 𝘭𝘦𝘵𝘳𝘢𝘴 𝘳”.
Al forzarla a escribir cada letra, las conviertes en tokens individuales (𝚜-𝚝-𝚛-𝚊-𝚠-𝚋-𝚎-𝚛-𝚛-𝚢) y, de repente, la IA «recupera la vista».

Si quieres, tienes un video en mi canal acerca de todo esto. Puedes verlo desde aquí.

¿Conocías este punto ciego de los modelos de lenguaje? ¿Qué otros fallos «absurdos» te has encontrado?

DevFest Ponferrada 2025: Innovación, IA y el Futuro de la Ingeniería 1024 576 juangmuelas
Dev Fest Ponferrada 2025

DevFest Ponferrada 2025: Innovación, IA y el Futuro de la Ingeniería

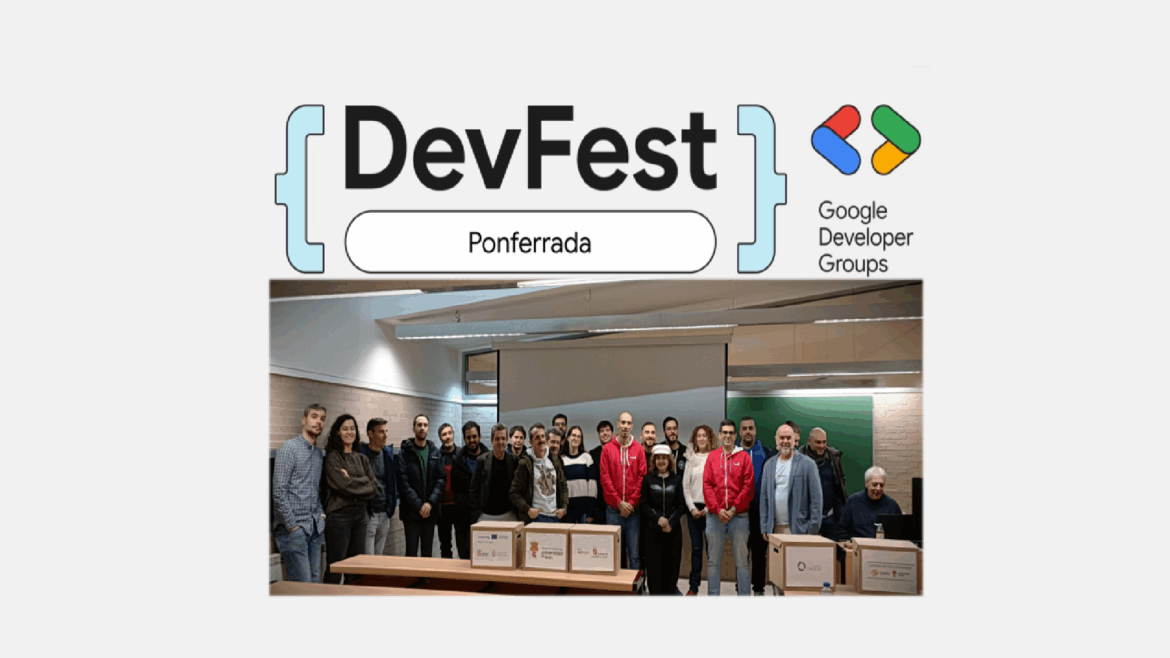
El pasado viernes tuve el placer de asistir a la DevFest Ponferrada 2025, un evento crucial organizado por el GDG Ponferrada que, con este año, se consolida como un punto de encuentro fundamental para la comunidad tecnológica del norte de España.

¿Qué es una DevFest?

Para contextualizar, las DevFests (Developer Festival) son una serie de conferencias tecnológicas que se celebran de forma global, lideradas y organizadas por los Google Developer Groups (GDG). Estos eventos son la celebración anual de la tecnología y están diseñados por organizadores locales, como el GDG Ponferrada, para adaptarse a las necesidades e intereses de su comunidad. El objetivo es simple: conectar a desarrolladores y profesionales, facilitar el aprendizaje práctico y compartir las últimas novedades en tecnologías de Google (como Android, Flutter, Google Cloud, o Gemini) y otros temas relevantes para el ecosistema.

Los DevFests son conocidos por su enfoque práctico y la calidad de sus ponencias, y esta edición no fue la excepción. A lo largo del día, pude sumergirme en seis charlas que cubrían desde la evolución del desarrollo móvil hasta las aplicaciones más disruptivas de la Inteligencia Artificial y la Realidad Virtual.

A continuación, os comparto mis principales aprendizajes y reflexiones sobre las sesiones a las que asistí.

🧠 Foco en Inteligencia Artificial, Machine Learning y Desarrollo

La IA generativa y los grandes modelos de lenguaje (LLMs) dominaron una parte significativa de la agenda, mostrando su rápido avance y su integración directa en el desarrollo de productos.

ADK con Gemini: Desarrollando Agentes y Mejorando Servicios

Una de las ponencias más prácticas fue la dedicada al ADK (Application Development Kit) con Gemini. Pude observar cómo la plataforma de Google facilita la creación de agentes sencillos desde cero. Más allá de la teoría, fue especialmente revelador el potencial que ofrece para mejorar servicios existentes, como la demostración de convertir una simple imagen estática en un video dinámico, todo gracias a la capacidad multimodal de Gemini y siguiendo la documentación y workflows propuestos por Google.

Vision Language Models (VLM): Comprendiendo los Conceptos Clave

En un contexto más fundamental, la sesión sobre Vision Language Models ofreció una panorámica magnífica y necesaria. Se abordaron todos los conceptos generales que subyacen a estos modelos que fusionan la visión por computador y el procesamiento de lenguaje natural. Fue una excelente explicación para clarificar cómo la tecnología interpreta y relaciona el texto con el contenido visual en un solo modelo unificado.

Construyendo Experiencias Inclusivas con GenAI y el Lenguaje de Signos

Esta charla destacó por su enfoque en el impacto social. Se presentó un caso práctico sobre cómo utilizar la IA Generativa no solo como una herramienta de productividad, sino como un medio para crear experiencias verdaderamente inclusivas. La aplicación del machine learning al lenguaje de signos es un ejemplo poderoso de cómo la tecnología puede reducir barreras y promover la accesibilidad en productos y servicios digitales.

💻 Arquitectura y Evolución del Desarrollo

El evento también dedicó espacio a la evolución de las prácticas de ingeniería y la arquitectura de software, áreas fundamentales para la escalabilidad y el mantenimiento de sistemas complejos.

Layouts Adaptativos: El Salto en Desarrollo Android

La sesión sobre Layouts adaptativos en Android fue de gran interés para quienes trabajamos en el ecosistema móvil. Pude constatar la significativa evolución, desde las complejas configuraciones basadas en ficheros XML que predominaban hasta hace poco, hasta la tendencia actual de unificar el desarrollo de interfaces en las nuevas versiones del sistema. Un movimiento clave hacia la simplicidad y la consistencia entre diferentes factores de forma.

De DevSecOps a Platform Engineering: Cuándo «Elevar» a Plataforma

Un tema candente en la ingeniería moderna es la transición de DevSecOps hacia el enfoque de Platform Engineering. La ponencia aportó una claridad vital sobre la definición de este nuevo rol y, lo más importante, sobre los criterios y el momento adecuado para «elevar» un conjunto de herramientas y servicios internos a una Plataforma Interna de Desarrollo (Internal Developer Platform – IDP). Una guía crucial para la toma de decisiones arquitectónicas.

🔬 Innovación Tecnológica con Impacto

Finalmente, la DevFest nos recordó que la tecnología no solo optimiza procesos, sino que puede transformar campos enteros, como el de la salud.

Dose.VR() y el Uso de Iniciativas de Inmersión en Terapias

La charla Dose.VR() exploró la aplicación de la Realidad Virtual (VR) como iniciativa de inmersión en el ámbito terapéutico. Fue una demostración fascinante del potencial de las tecnologías inmersivas durante los tratamientos, el manejo del dolor o la rehabilitación. Una prueba tangible de que la tecnología va mucho más allá de las pantallas que usamos a diario.

Conclusión: El Espíritu del GDG Ponferrada

La DevFest Ponferrada 2025, para mí, fue un rotundo éxito. La calidad de los speakers y la variedad de temas cubiertos ofrecieron una visión de 360 grados sobre el panorama tecnológico actual.

Mi sincera enhorabuena al equipo organizador del Google Developer Group de Ponferrada. Este grupo sin ánimo de lucro, formado por desarrolladores y entusiastas, tiene la misión de aprender e intercambiar conocimientos sobre tecnologías de Google y otras áreas. Liderado por David Martínez, Jaime Riesco y TxeTxu A. Alvarez, el GDG Ponferrada demuestra cómo la pasión por la tecnología y la colaboración pueden crear eventos de referencia y un gran ambiente comunitario.

Eventos como este son esenciales para mantenernos al día y fomentar el networking dentro de nuestra comunidad. ¡Ya estoy esperando con ilusión la próxima edición!

La Estructura SÍ Importa: Por Qué Debes Usar Markdown y Saltos de Línea en tus Prompts de IA 1024 576 juangmuelas
Domina-tus-prompts-con-markdown

La Estructura SÍ Importa: Por Qué Debes Usar Markdown y Saltos de Línea en tus Prompts de IA

Introducción: El Desafío del Párrafo Denso

Todos hemos empezado redactando prompts como una única y larga frase, separando las ideas con comas. Aunque la IA es increíblemente inteligente, esta práctica introduce un ruido innecesario que sabotea la precisión.

Si buscas que tu código sea perfecto, que tu plan de clase esté impecable o que tu post resulte magnético, la clave está en cómo le presentas las instrucciones. No se trata solo del qué pides, sino del cómo lo pides. El secreto es el formato.

El Formato como «Lenguaje de Programación» para la IA

Olvídate de pensar en el prompt como un simple mensaje de chat; considéralo un documento técnico de requerimientos.

Los modelos de lenguaje (LLMs) como Gemini o ChatGPT han sido entrenados con millones de documentos estructurados (código, informes técnicos, artículos de Wikipedia). Entienden la jerarquía visual. Por eso, usar Markdown no es solo una cuestión de estética; es un truco de ingeniería que el modelo interpreta como:

  • Delimitación Fuerte: Le estás indicando dónde empieza y dónde termina una instrucción crucial.
  • Priorización Semántica: El modelo asigna un «peso» mayor a lo que está marcado con formato (encabezados, listas), sabiendo que esas son las directivas estructurales que debe priorizar.

Por Qué la Estructura Supera al Contexto

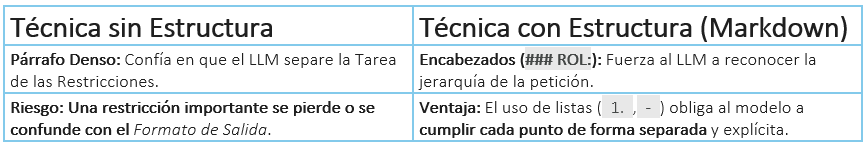
Aunque los LLMs son capaces de inferir un ROL o una TAREA por contexto, la inferencia es una fuente de error. La estructura elimina esa ambigüedad:

tabla comparativa estructuras prompt

La Mejor Práctica: Crea tu Plantilla Externa

Como muchos desarrolladores y docentes hacemos, la técnica más efectiva es redactar tus prompts complejos fuera de la interfaz de chat (en un documento de texto, editor de código o Word).

Esto te permite:

  1. Refinar y Guardar: Tienes una biblioteca de prompts maestras que puedes reutilizar y optimizar.
  2. Pegar el Formato Perfecto: Al copiar y pegar el texto estructurado, el LLM procesa inmediatamente el Markdown (los ###, los -, los espacios y los saltos de línea), garantizando la máxima claridad.

Conclusión

Si tus prompts son complejos (generación de código, planificación de cursos, análisis de ciberseguridad), no dejes la precisión al azar. Adopta esta técnica de Ingeniería de Prompts Avanzada: usa Markdown para estandarizar tus peticiones y obliga a la IA a seguir tu estructura.

Es una forma sencilla de reducir la entropía de la comunicación y obtener respuestas más rápidas, limpias y utilizables en tu trabajo diario.


¿Buscas ejemplos de plantillas estructuradas? Puedes ver este video en mi canal, para ver cómo aplicar esta técnica a tareas de código y docencia.

Jag Molar

Resumen de privacidad

Esta web utiliza cookies para que podamos ofrecerte la mejor experiencia de usuario posible. La información de las cookies se almacena en tu navegador y realiza funciones tales como reconocerte cuando vuelves a nuestra web o ayudar a nuestro equipo a comprender qué secciones de la web encuentras más interesantes y útiles.